SAND se convierte en distribuidor de las soluciones de Mind para impulsar su expansión en el mercado
Artículos Artículos

SAND se convierte en distribuidor de las soluciones de Mind para impulsar su expansión en el mercado

La alianza une la capacidad de innovación y desarrollo de producto de Mind con la experiencia de SAND en proyectos de Data, Analytics e Inteligencia Artificial.

Mind Analytics, S.L. (Mind), compañía tecnológica especializada en soluciones de Data, Analytics e Inteligencia Artificial, anuncia un acuerdo estratégico con Sistemas de Análisis y Navegación de Datos, S.L. (SAND), por el que esta última se convierte en distribuidor de las soluciones y productos de Mind.

La alianza nace con el objetivo de acelerar la expansión y adopción de las soluciones de Mind, ampliando su capacidad comercial y de implantación a través de un socio con una amplia trayectoria en el mercado español y un profundo conocimiento del ecosistema de datos.

SAND cuenta con más de dos décadas de experiencia desarrollando proyectos de Data Management, Business Intelligence y Analytics para organizaciones de múltiples sectores. Su experiencia en la implantación de plataformas de datos y analítica, junto con su conocimiento de las necesidades reales de las organizaciones, convierten a SAND en un socio estratégico para acompañar el crecimiento de las soluciones desarrolladas por Mind.

Para Mind, el acuerdo supone un nuevo paso en su estrategia de evolución hacia una compañía cada vez más orientada a producto, construyendo un ecosistema de partners capaces de comercializar, implantar y acompañar a los clientes en la adopción de sus soluciones.

En Mind llevamos años desarrollando tecnología para ayudar a las empresas a obtener más valor de sus datos. El siguiente paso natural es ampliar nuestra capacidad de llegar al mercado a través de socios que compartan nuestra visión y, sobre todo, que tengan la capacidad técnica para llevarla a la práctica. SAND es un partner excepcional para nosotros: conoce profundamente el mundo del dato, entiende las necesidades de las empresas y cuenta con una enorme experiencia ejecutando proyectos complejos de Data, Analytics e IA a escala.

— Joaquín Oroño, CEO de Mind

La colaboración permitirá combinar las soluciones tecnológicas desarrolladas por Mind con las capacidades de consultoría, integración e implantación de SAND, facilitando a las organizaciones abordar proyectos que cubren todo el ciclo de valor del dato: desde su integración y gobierno hasta la analítica avanzada y la aplicación de Inteligencia Artificial.

Mind es una compañía que ha sabido convertir la experiencia acumulada en numerosos proyectos de Data y Analytics en tecnología aplicada a necesidades concretas del mercado. Sus soluciones nacen de problemas y necesidades que ya han sido abordados en proyectos reales, lo que nos permite partir de soluciones contrastadas y acelerar significativamente las implantaciones. Para nuestros clientes esto aporta un enorme valor: podemos acelerar la adopción de un dato gobernado y sentar rápidamente las bases para desplegar Inteligencia Artificial a escala, que es precisamente una de las principales demandas que estamos viendo hoy en las organizaciones.

— Jesús Cristóbal, Director de SAND

Una alianza para llevar la innovación a escala

El acuerdo forma parte de la estrategia de Mind para desarrollar una red de partners especializados que permita llevar sus productos a un mayor número de organizaciones y mercados, manteniendo al mismo tiempo un alto nivel de especialización y calidad en las implantaciones.
La combinación de ambas compañías crea una propuesta especialmente sólida: producto e innovación tecnológica por parte de Mind, junto con la experiencia, conocimiento del mercado y capacidad de ejecución de SAND.

Ambas compañías trabajarán conjuntamente en la identificación de nuevas oportunidades, el desarrollo de proyectos y la implantación de soluciones de Data, Analytics e Inteligencia Artificial.

Sobre Mind
Mind Analytics, S.L., que opera comercialmente como Mind, es una compañía tecnológica especializada en Data, Analytics e Inteligencia Artificial que desarrolla soluciones para ayudar a las organizaciones a transformar sus datos en información útil, gobernada y accionable.
Con más de una década de experiencia en proyectos de datos y analítica, Mind combina su conocimiento tecnológico y de negocio con el desarrollo de productos propios orientados a resolver necesidades reales de las organizaciones.

Sobre SAND
Sistemas de Análisis y Navegación de Datos, S.L., que opera comercialmente como SAND, es una compañía especializada en Data Management, Business Intelligence y Analytics. Desde 2002 ofrece servicios de consultoría, implantación, desarrollo y formación alrededor de las principales tecnologías analíticas, ayudando a las organizaciones a transformar sus datos en conocimiento para mejorar la toma de decisiones.
Su experiencia abarca proyectos de integración, gestión y explotación de datos para compañías de diferentes tamaños y sectores.

¿Tienes un proyecto?

Llevamos más de 15 años ayudando a empresas a conseguir sus objetivos. Somos creativos, tenaces y nos encanta lo que hacemos.

¡Hagamos esa idea realidad!
Mews ya está integrado con Mind Hotel Insights
Artículos Artículos

Mews ya está integrado con Mind Hotel Insights

Conecta Mews con Mind Hotel Insights y transforma tus datos financieros, operativos y comerciales en una visión única para analizar ocupación, ingresos, pickup, GOP y EBITDA de forma más ágil.

Si trabajas con Mews, ahora puedes conectar tus datos directamente con Mind Hotel Insights y llevar el análisis hotelero un paso más allá.

La integración permite incorporar la información operativa y comercial de Mews dentro de una visión consolidada del negocio, combinándola con otras fuentes para analizar el rendimiento del hotel desde una única plataforma.

Con Mind Hotel Insights puedes:

  • Analizar ocupación, ADR y RevPAR.
  • Seguir la evolución del pickup.
  • Comparar periodos, hoteles y segmentos.
  • Automatizar reporting.
  • Combinar datos operativos, comerciales y financieros.
  • Obtener una visión más completa de la rentabilidad de forma automática
  • Integrar con agentes de IA y con Claude, ChatGPT o Gemini

El objetivo es sencillo: menos tiempo preparando datos y más tiempo tomando decisiones.

👉 Descubre esta y todas nuestras integraciones: https://wearemind.io/integraciones/

¿Tienes un proyecto?

Llevamos más de 15 años ayudando a empresas a conseguir sus objetivos. Somos creativos, tenaces y nos encanta lo que hacemos.

¡Hagamos esa idea realidad!
Revenue Management agéntico: cuando la IA pasa de recomendar a actuar
Artículos Artículos

Revenue Management agéntico: cuando la IA pasa de recomendar a actuar

La siguiente evolución del Revenue Management no consiste en tener otro dashboard ni un forecast más preciso. Consiste en agentes de IA capaces de interpretar la demanda, decidir qué hacer, ejecutar cambios sobre los sistemas del hotel y aprender del resultado.

Durante años, la tecnología aplicada al Revenue Management ha ayudado a los hoteles a entender el pasado y anticipar el futuro. El siguiente salto es diferente: pasar de sistemas que informan y recomiendan a agentes de IA capaces de analizar, decidir y actuar.

Un aumento inesperado de búsquedas. Un evento que dispara la demanda de un destino. Un pickup que acelera. Un competidor que modifica su estrategia. Una tipología de habitación que empieza a agotarse demasiado rápido.

Hoy, buena parte de estas señales termina delante de una persona. El Revenue Manager interpreta lo que está ocurriendo, decide qué hacer y ejecuta el cambio en el PMS, RMS o channel manager.

La IA agéntica introduce una posibilidad mucho más profunda: que parte de ese ciclo pueda producirse de forma autónoma, gobernada y en tiempo real.

Del Revenue Management asistido al Revenue Management agéntico

La primera generación de Business Intelligence hotelero respondió principalmente a una pregunta: ¿qué ha pasado?

La analítica predictiva añadió otra: ¿qué creemos que va a pasar?

Los sistemas de recomendación avanzaron un paso más: ¿qué deberíamos hacer?

El Revenue Management agéntico añade la pieza que faltaba: hazlo, mide qué ha ocurrido y vuelve a decidir.

Ese cambio parece pequeño, pero transforma por completo el papel de la tecnología. El software deja de ser únicamente una herramienta que espera una interacción humana y empieza a convertirse en un participante activo dentro del proceso de decisión.

¿Qué es realmente un agente de Revenue Management?

No estamos hablando simplemente de conectar ChatGPT, Claude o Gemini a los datos del hotel y hacerles preguntas.

Un agente necesita contexto, herramientas, reglas y capacidad de ejecución. Debe saber qué hotel está gestionando, qué significa cada KPI, qué restricciones existen, qué acciones tiene permitidas y a través de qué sistemas puede ejecutarlas.

En un escenario avanzado, el agente podría trabajar con información procedente de:

  • PMS y reservas.
  • Booking engine y canal directo.
  • Channel manager.
  • Pickup y booking pace.
  • Histórico de ocupación, ADR y RevPAR.
  • Precios y disponibilidad de la competencia.
  • Eventos locales y calendario.
  • Datos meteorológicos.
  • Campañas de marketing y CRM.
  • Presupuesto, forecast y objetivos de revenue.

La diferencia está en que el agente no se limita a resumir esta información. La utiliza para evaluar una situación y determinar cuál es la siguiente acción.
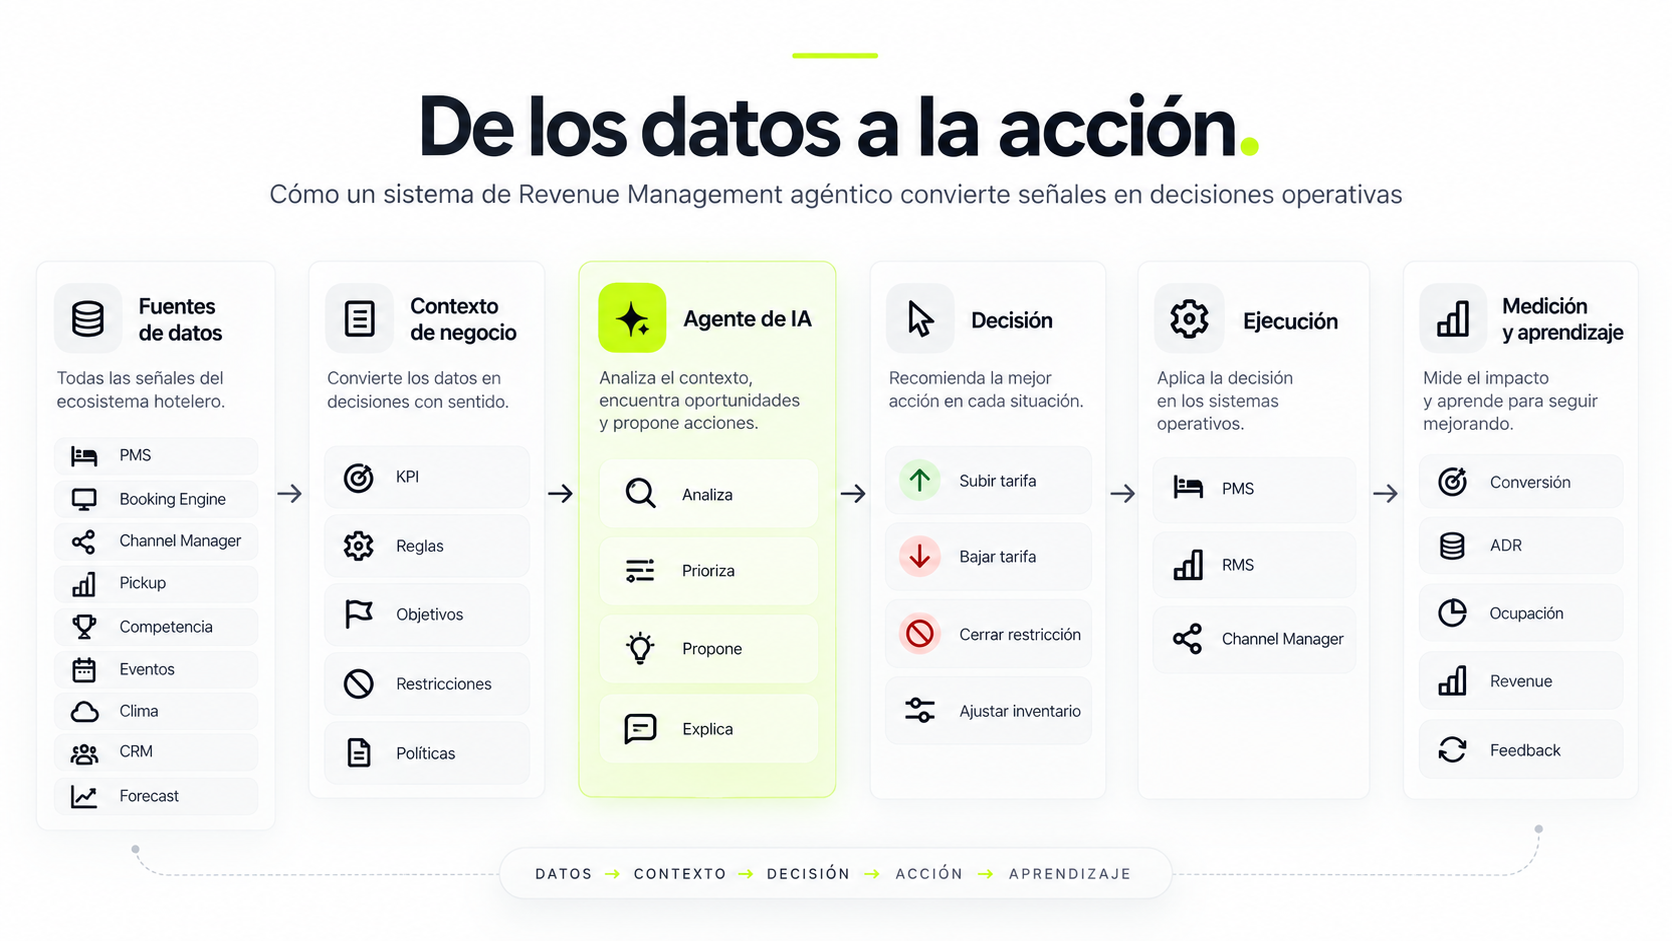
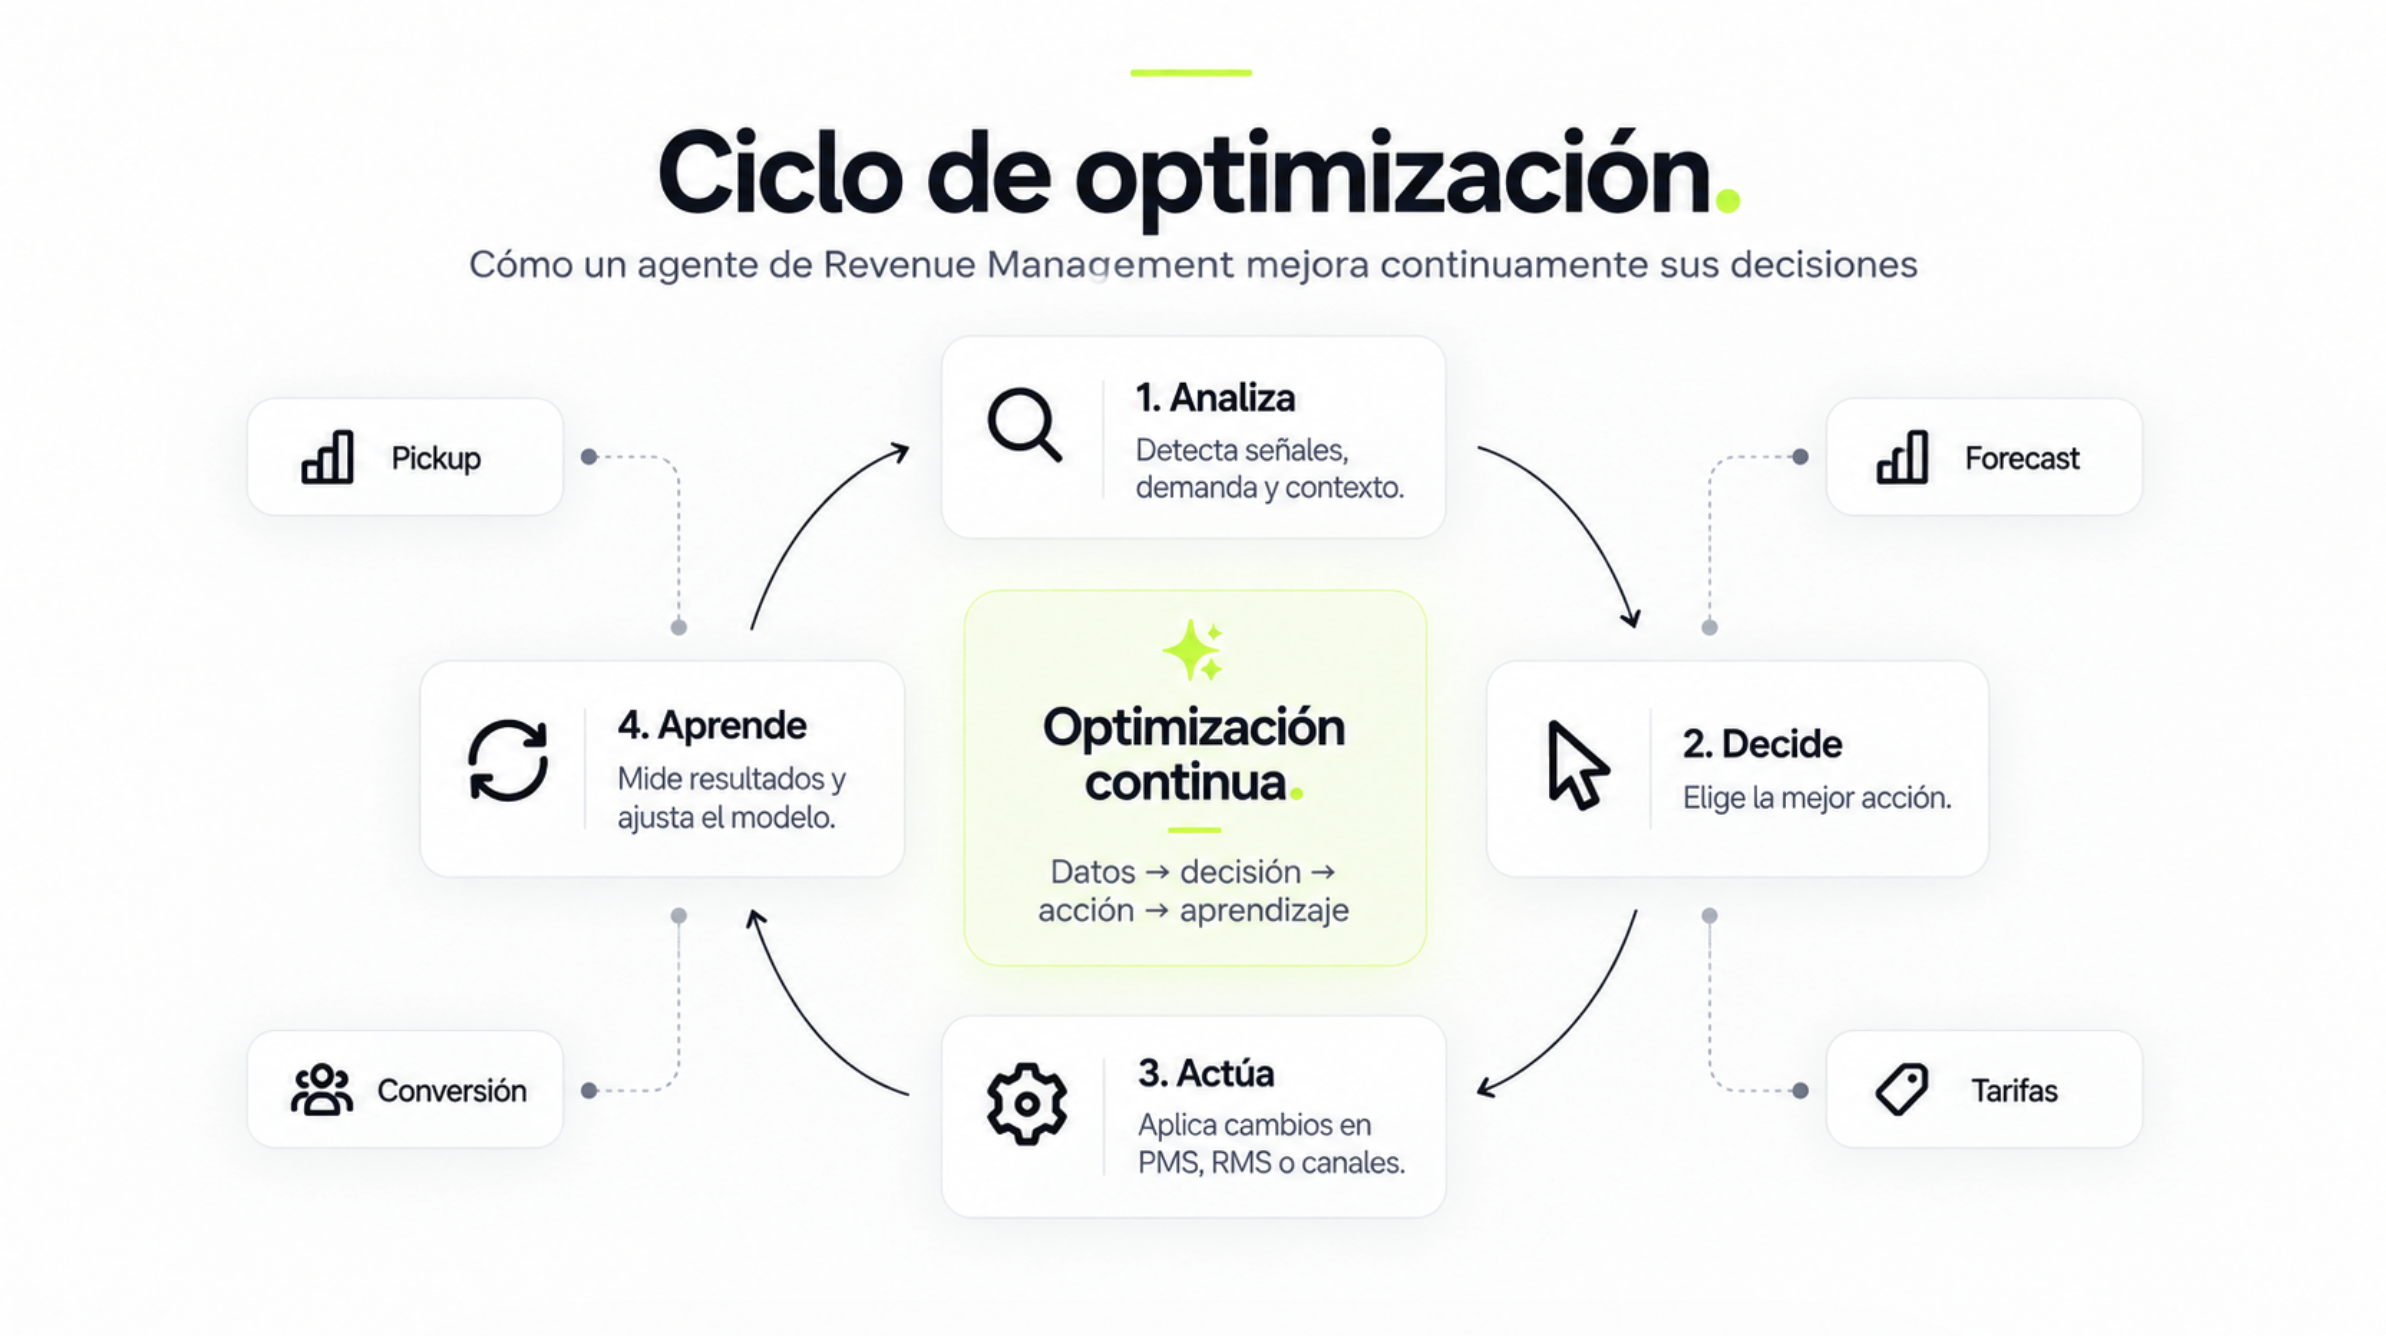
El modelo puede entenderse como un ciclo continuo.

1. Analiza

El agente monitoriza continuamente señales internas y externas. Detecta cambios de demanda, desviaciones frente al forecast, aceleraciones de pickup, variaciones de disponibilidad o comportamientos que merecen atención.

2. Decide

Cuando identifica una oportunidad o un riesgo, evalúa diferentes alternativas dentro de las reglas definidas por el negocio.

Puede determinar, por ejemplo, que la tarifa de una habitación está por debajo de la que justificaría la demanda actual, que conviene cerrar una restricción o que una determinada fecha requiere una estrategia diferente.

3. Actúa

Aquí aparece la gran diferencia frente a la analítica tradicional.

Si dispone de permisos y de las integraciones necesarias, el agente puede ejecutar la acción sobre el sistema correspondiente: modificar una tarifa, aplicar una restricción, actualizar inventario, generar una alerta o solicitar aprobación humana.

4. Aprende

La acción genera un resultado. El agente puede medir cómo evolucionaron pickup, conversión, ocupación, ADR o ingresos después de la decisión y utilizar ese feedback en la siguiente evaluación.

El Revenue Management deja así de ser una secuencia de análisis aislados para convertirse en un ciclo continuo de optimización.
Un ejemplo: la demanda cambia un martes a las 11:32

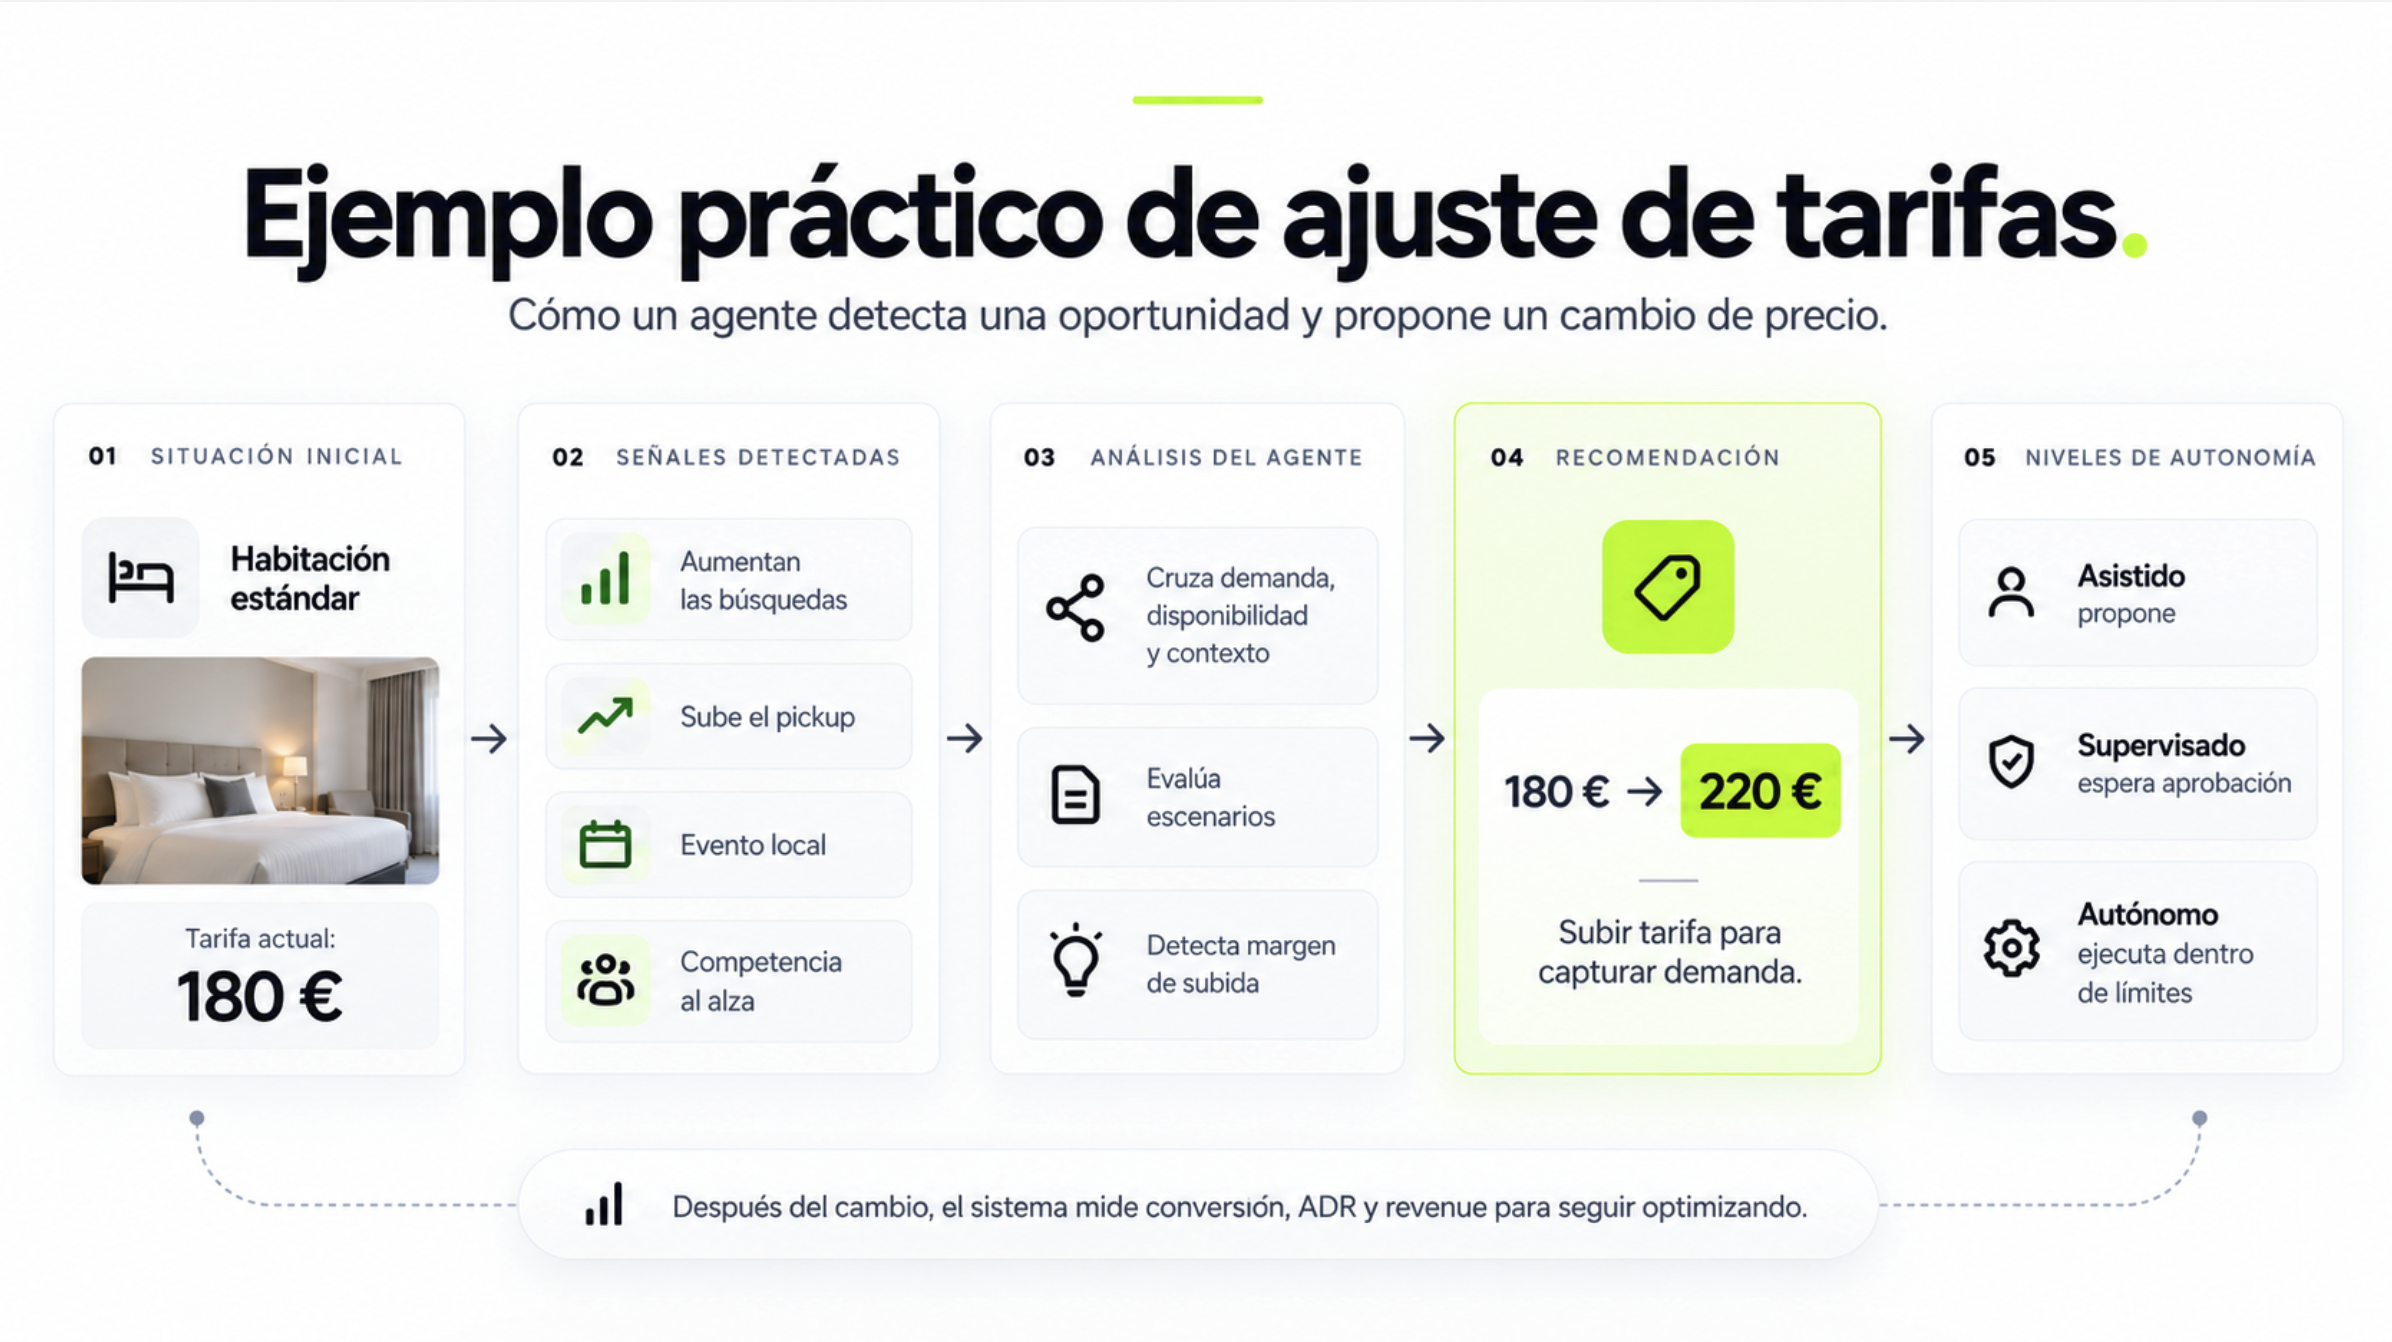
Imaginemos un hotel cuya habitación estándar está vendiéndose a 180 € para un fin de semana dentro de seis semanas.

A las 11:32 el sistema detecta que las búsquedas para el destino están creciendo significativamente. El pickup del hotel empieza a acelerar y aparece un evento local que no estaba contemplado en el forecast inicial.

Un dashboard puede mostrarlo.

Un sistema de alertas puede avisarlo.

Un modelo predictivo puede recalcular la demanda.

Un agente puede hacer algo más.

Puede cruzar esas señales con disponibilidad, ritmo de reservas, histórico, competencia y objetivos del hotel. Puede simular diferentes escenarios y concluir que existe margen para incrementar la tarifa de 180 € a 220 €.

A partir de ahí existen diferentes niveles de autonomía.

Modo asistido: propone el cambio al Revenue Manager y explica por qué.

Modo supervisado: prepara la acción y espera aprobación antes de ejecutarla.

Modo autónomo: ejecuta directamente el cambio dentro de unos límites previamente definidos.

Y después sigue observando.

Si la demanda responde como esperaba, mantiene o vuelve a optimizar. Si la conversión cae más de lo previsto, puede reconsiderar la decisión.

Eso es lo verdaderamente interesante de la IA agéntica: no una decisión aislada, sino un sistema capaz de cerrar el ciclo entre dato, decisión, acción y resultado.

La autonomía no tiene por qué ser todo o nada

Cuando se habla de agentes autónomos es fácil imaginar una IA cambiando libremente las tarifas de un hotel sin intervención humana.

No tiene por qué funcionar así.

En un entorno empresarial, la autonomía puede diseñarse.

Un hotel podría permitir cambios automáticos de hasta un 5 %, exigir aprobación entre un 5 % y un 15 % y bloquear cualquier modificación superior. Podría impedir que una tarifa bajara de un determinado floor, definir techos por tipología o exigir intervención humana en fechas consideradas estratégicas.

También puede determinar qué acciones son reversibles, qué usuarios deben ser informados y qué decisiones necesitan conservar una explicación completa.

La pregunta deja de ser “¿dejamos que la IA tome decisiones?” y pasa a ser “¿qué decisiones queremos delegar, bajo qué condiciones y con qué nivel de supervisión?”

El Revenue Manager no desaparece. Cambia de nivel.

La consecuencia más interesante no es sustituir al Revenue Manager.

Es eliminar una enorme cantidad de microdecisiones y tareas operativas para que pueda concentrarse en aquello donde aporta más valor: estrategia, segmentación, posicionamiento, distribución, eventos excepcionales, coordinación comercial y definición de las reglas que debe seguir el sistema.

En lugar de pasar el día buscando qué fechas necesitan atención, puede gestionar por excepción.

El agente vigila miles de señales. El profesional interviene donde el contexto, la estrategia o el impacto requieren criterio humano.

Un agente necesita mucho más que un LLM

Aquí está uno de los puntos que probablemente marcará la diferencia entre una demo espectacular y una implementación empresarial real.

El modelo de lenguaje es solo una pieza.

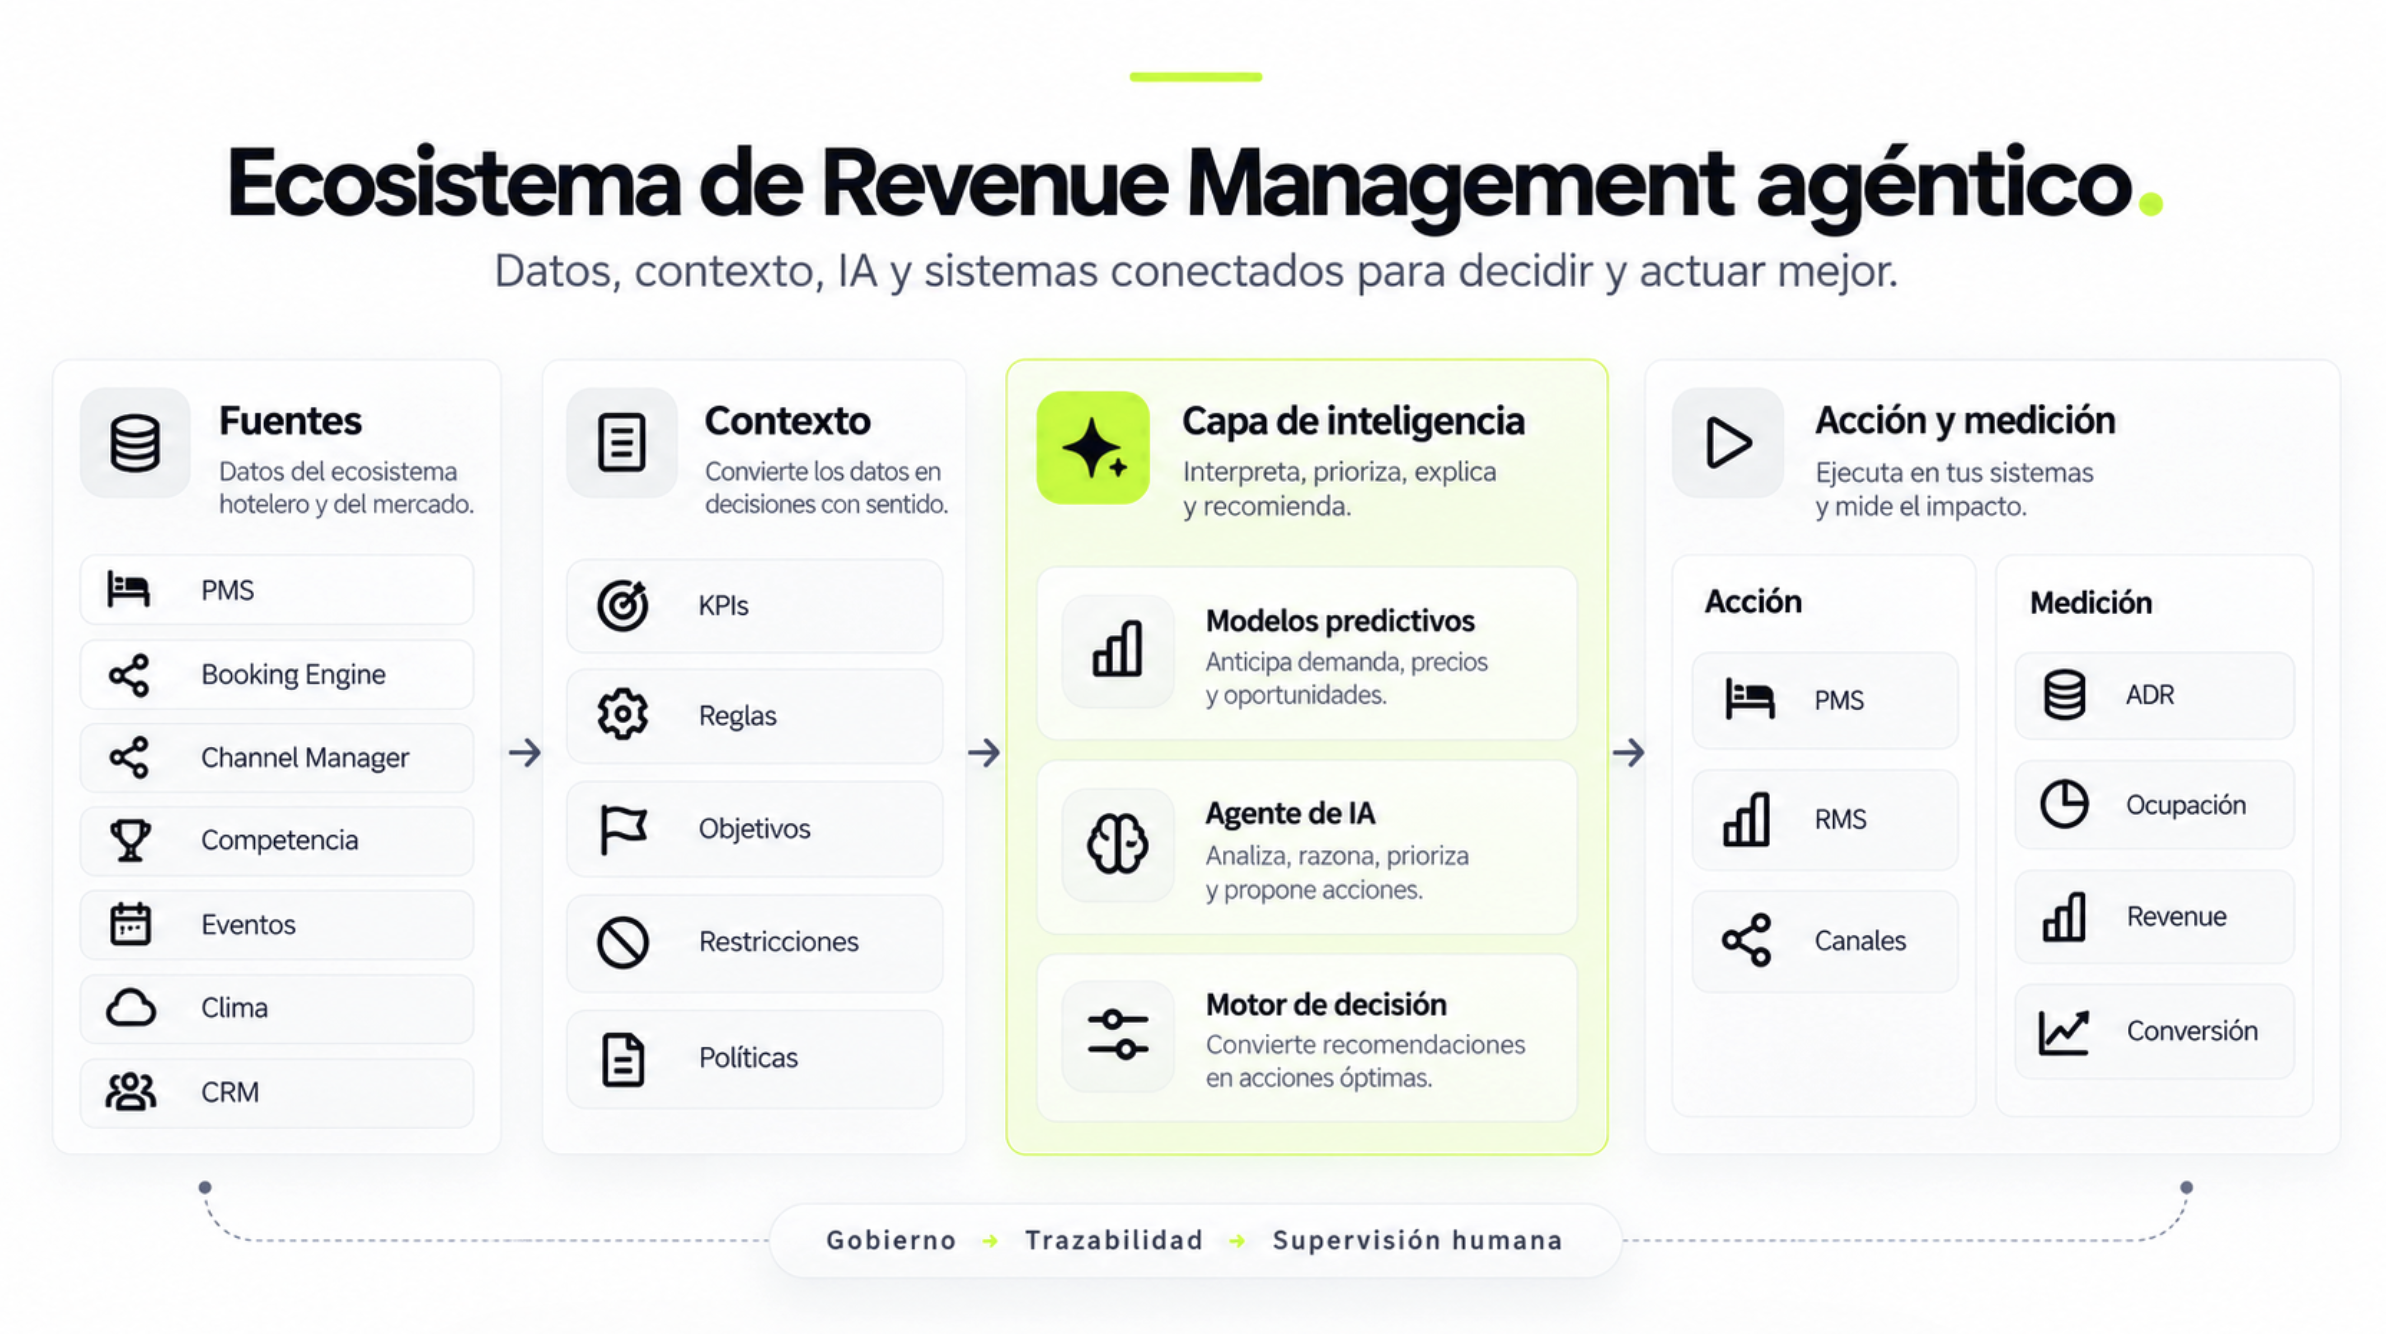
Para que un agente pueda operar de forma fiable necesita una arquitectura alrededor:

  • Datos fiables: reservas, tarifas, inventario, históricos y contexto deben estar disponibles y correctamente modelados.
  • Contexto de negocio: el agente debe comprender métricas, jerarquías, políticas y objetivos.
  • Herramientas: necesita APIs o mecanismos seguros para consultar y ejecutar acciones.
  • Gobierno: permisos, límites, trazabilidad, aprobaciones y auditoría.
  • Observabilidad: debemos saber qué decidió, por qué lo decidió, qué ejecutó y cuál fue el resultado.

Sin estas capas, tenemos un chatbot conectado a datos. Con ellas, empezamos a tener un verdadero sistema agéntico empresarial.
¿ChatGPT, Claude o Gemini?

Probablemente esta sea una de las preguntas menos importantes de toda la arquitectura.

Los modelos evolucionan rápidamente y cada uno puede presentar ventajas diferentes. Una arquitectura bien diseñada debería evitar que la lógica de negocio dependa completamente de un único modelo.

El activo estratégico no es únicamente el LLM.

Son los datos, el contexto, las reglas, las integraciones y el conocimiento del negocio que rodean al modelo.

El modelo puede cambiar. El conocimiento de cómo funciona tu hotel no debería empezar de cero cada vez.

De la recomendación a la ejecución
Durante años hemos construido sistemas para que las personas pudieran tomar mejores decisiones con datos.

La IA agéntica abre una etapa distinta: sistemas capaces de participar directamente en esas decisiones y, cuando corresponde, ejecutarlas.

En Revenue Management esta evolución resulta especialmente natural porque confluyen todos los ingredientes: grandes volúmenes de datos, decisiones frecuentes, objetivos medibles, sistemas conectables y un feedback rápido sobre el resultado.

El cambio importante no será que podamos preguntarle a una IA:

“¿Qué tarifa debería tener este hotel el próximo sábado?”

El cambio llegará cuando el sistema sea capaz de detectar que existe una oportunidad antes de que se lo preguntemos, entender por qué, decidir qué hacer, ejecutar la acción dentro de las políticas definidas y comprobar después si funcionó.

Ahí es cuando la Inteligencia Artificial deja de ser una interfaz y empieza a convertirse en una nueva capa operativa del hotel.

El futuro no es un dashboard más

Los dashboards seguirán siendo necesarios. Los forecasts también. Y el criterio del Revenue Manager seguirá siendo fundamental.

Pero la próxima frontera no consiste en mostrar más información en una pantalla.

Consiste en reducir la distancia entre detectar una oportunidad y actuar sobre ella.

Datos → contexto → decisión → acción → aprendizaje.

Ese ciclo puede ser una de las transformaciones más importantes del Revenue Management hotelero de los próximos años, y en Mind ya estamos orquestando el cambio, quieres ver como funciona? 👇
¿Tienes un proyecto?

Llevamos más de 15 años ayudando a empresas a conseguir sus objetivos. Somos creativos, tenaces y nos encanta lo que hacemos.

¡Hagamos esa idea realidad!
El dilema de los CIOs (y CEOs)
Artículos Artículos

El dilema de los CIOs (y CEOs)

El coste del software no desapareció. Simplemente cambió de sitio. La IA ha democratizado el desarrollo de software, pero no su mantenimiento. Al construir internamente, muchas empresas descubren que el verdadero coste reaparece en IT, sin la economía de escala de un proveedor SaaS.

Hace unos días, hablando con varios CIOs, me di cuenta de que casi todos compartían el mismo entusiasmo.

“Con la IA ahora podemos desarrollar nuestras propias aplicaciones.”

Y tienen razón. Nunca había sido tan sencillo convertir una idea en una aplicación funcional. Lo que hace apenas dos años requería meses de trabajo y un equipo de desarrollo, hoy puede estar funcionando en cuestión de días gracias a herramientas como Claude, Cursor, Copilot o ChatGPT. Hasta aquí, todo bien.

Mientras les escuchaba, me vino a la cabeza una conversación que creo que muchos CIOs tendrán dentro de un año. No será con su equipo ni con el proveedor de turno. Será con el CEO.

Llegarán con una aplicación funcionando, usuarios satisfechos y la sensación de haber tomado una buena decisión. Al fin y al cabo, han dejado de pagar una licencia anual y han demostrado que, gracias a la IA, son capaces de desarrollar internamente aquello que antes compraban fuera.

Y ahí empezará la verdadera conversación.

Porque, una vez que la aplicación entra en producción, empieza una etapa de la que casi nadie habla cuando se hace el business case. Aparecen las incidencias, cambian las necesidades del negocio, evolucionan las integraciones, se publican nuevas versiones de las librerías, se consumen tokens, hay costes de infraestructura y, casi sin darse cuenta, el equipo deja de dedicar tiempo a construir para empezar a dedicarlo a mantener.

Y es entonces cuando el ahorro inicial empieza a diluirse.

No porque la IA haya dejado de ser útil. Al contrario. La IA habrá cumplido exactamente lo que prometía: reducir de forma drástica el coste de desarrollar software. Lo que ocurre es que el desarrollo solo representa una parte del problema. La otra, la que acompaña a cualquier aplicación durante toda su vida útil, sigue estando ahí.

Durante años hemos pensado que una licencia SaaS era cara. En realidad, muchas veces era sorprendentemente barata. No porque desarrollar ese software costara poco, sino porque el coste de mantenerlo se repartía entre cientos o miles de clientes.

Esa es la gran ventaja de la economía de escala. Un proveedor desarrolla una funcionalidad una vez, corrige un error una vez, adapta una integración una vez… y ese esfuerzo beneficia a todos sus clientes.

Cuando una empresa decide desarrollar esa misma aplicación para uso interno, esa economía de escala desaparece.

A partir de ese momento, cada incidencia, cada nueva funcionalidad, cada actualización de seguridad y cada cambio solicitado por el negocio recaen sobre un único departamento de IT.

Y ese es el coste que rara vez aparece en la hoja de cálculo cuando se decide desarrollar una aplicación en lugar de comprarla.

No creo que esto sea un argumento para dejar de utilizar IA. Sería absurdo. Estamos viviendo el mayor salto en productividad del desarrollo de software que hemos visto en décadas y las empresas que sepan aprovecharlo tendrán una ventaja competitiva enorme.

Lo que sí creo es que, antes de sustituir una licencia SaaS por una aplicación desarrollada internamente, merece la pena hacerse una pregunta más importante que “¿podemos construirla?”.

La pregunta es:

¿Queremos mantenerla durante los próximos diez años?

Porque sospecho que, dentro de no mucho, muchos CIOs volverán al despacho del CEO.

  • ¿Recuerdas aquella aplicación que desarrollamos con IA?
    • Claro.
  • Necesitamos contratar dos personas más.

No porque el proyecto haya salido mal. Precisamente porque ha salido bien. Porque ahora forma parte del negocio. Y alguien tiene que mantenerlo. Ese día muchas empresas descubrirán que el coste del software nunca desapareció.

Simplemente cambió de sitio.

¿Tienes un proyecto?

Llevamos más de 15 años ayudando a empresas a conseguir sus objetivos. Somos creativos, tenaces y nos encanta lo que hacemos.

¡Hagamos esa idea realidad!
El vacío en el stack de datos
Artículos Artículos

El vacío en el stack de datos

Tienes Databricks. Tienes dbt. Tienes Power BI. Tu stack es moderno y escalable. Y aun así, cuando alguien pregunta qué significa un campo, la respuesta llega dos días después por Slack. Algo falta en el stack. Y no es tecnología.

No tener esa herramienta tiene un coste real, aunque sea difícil de cuantificar.

Los cierres de mes se alargan porque los datos no cuadran y nadie sabe cuál es la versión correcta de los criterios. Los proyectos de IA se retrasan porque los modelos necesitan datos limpios y bien definidos que no existen como tal. Las iniciativas de analítica avanzada se apoyan en definiciones que cada área interpreta de forma distinta. Y el equipo de datos dedica una parte significativa de su tiempo a responder preguntas que deberían tener respuesta en un sistema, no en una conversación.

El vacío en el stack no es un problema técnico. Es un problema de gobierno. Y el gobierno del dato no puede vivir en Excel

Qué debería existir

Una herramienta construida específicamente para gestionar datos contextuales debería permitir:

  • Definir datos maestros con estructura, tipos y validaciones
  • Asignar propietarios a cada dato y a cada campo
  • Versionar los cambios con auditoría completa
  • Aprobar cambios con flujos de revisión
  • Sincronizar automáticamente con el data warehouse
  • Ser accesible para el equipo de datos sin fricción técnica

Eso es lo que debería existir en el stack. No como un proyecto de consultoría de seis meses. No como una implementación enterprise con un coste de seis cifras. Como una herramienta operativa que cualquier equipo de datos pueda usar desde el primer día.

El vacío existe. Ya era hora de llenarlo.

¿Tienes un proyecto?

Llevamos más de 15 años ayudando a empresas a conseguir sus objetivos. Somos creativos, tenaces y nos encanta lo que hacemos.

¡Hagamos esa idea realidad!
Por qué el equipo de datos acaba en Excel (y no es culpa suya)
Artículos Artículos

Por qué el equipo de datos acaba en Excel (y no es culpa suya)

El equipo de datos no usa Excel porque quiere. Lo usa porque no existe otra herramienta específica para gobernar el contexto de los datos. Este es el problema que nadie ha resuelto todavía — y el coste invisible que nadie calcula.

Hay una conversación que se repite en casi todos los equipos de datos que conocemos. Alguien del negocio pregunta por un dato. El equipo de datos lo busca en el warehouse, no encuentra el contexto que necesita para responder con seguridad, y acaba preguntando a la persona que lleva más tiempo en la empresa. Esa persona abre un Excel.

No es un fallo del equipo. Es el síntoma de un problema estructural que nadie ha resuelto todavía.

El equipo de datos no elige Excel

Cuando alguien de fuera del mundo de los datos imagina a un Data Engineer o un Data Manager, probablemente no los imagina trabajando en Excel. Los imagina con SQL, con Python, con dashboards en Looker o con pipelines en dbt. Y en su mayor parte, así es.

Pero hay una categoría de información que no cabe en ninguna de esas herramientas. Y esa información acaba, inevitablemente, en una hoja de cálculo.

No porque el equipo no sepa hacer las cosas de otra forma. Sino porque no existe otra herramienta específica para hacerlo.

Qué es lo que no cabe en el warehouse

El data warehouse es extraordinariamente bueno para almacenar y procesar datos transaccionales a escala. Millones de filas de ventas, clics, eventos, transacciones. Todo eso vive perfectamente en BigQuery o Snowflake.

Lo que no vive bien ahí es el contexto de esos datos.

¿Qué es un cliente activo según el criterio de negocio actual? ¿Qué valores son válidos para el campo tipo_canal? ¿Cuándo se decidió que los clientes con más de 180 días sin comprar pasaban a la categoría de inactivos, y quién lo decidió? ¿Qué excepción aplica a los clientes del segmento corporativo?

Esas preguntas tienen respuesta. Pero esa respuesta no está en una tabla de BigQuery. Está en la memoria de alguien, en un email de hace dos años, en una reunión cuyas notas nadie guardó bien, o — con suerte — en un Excel que alguien creó para intentar centralizar todo eso.

El Excel como solución de emergencia permanente

El problema con usar Excel para esto no es Excel en sí. Excel es una herramienta brillante para lo que fue diseñada.

El problema es que Excel no fue diseñado para gobernar datos maestros en equipo. Y cuando lo usas para eso, aparecen los síntomas conocidos:

Versiones múltiples. El Excel de clientes tiene cuatro versiones en cuatro carpetas distintas. Nadie sabe cuál es la definitiva. Cuando hay discrepancias en un informe, la primera pregunta es siempre “¿qué versión estabas usando?”.

Sin propietario claro. ¿Quién es responsable de mantener ese Excel actualizado? En teoría, todos. En la práctica, nadie. Hasta que hay un problema.

Sin validación. Cualquier persona con acceso puede escribir cualquier cosa en cualquier celda. No hay reglas. No hay alertas. No hay forma de saber si el dato que acaban de introducir es correcto.

Sin auditoría. ¿Quién cambió ese valor y cuándo? Excel no lo sabe. Si alguien modificó un criterio de clasificación el mes pasado, no hay registro de ello a menos que alguien lo haya documentado manualmente.

Sin sincronización. El Excel vive desconectado del warehouse. Cuando algo cambia en el Excel, alguien tiene que acordarse de actualizarlo también en el sistema. A veces lo hace. A veces no.

Por qué el equipo lo sigue usando

Con todo eso, ¿por qué el equipo de datos sigue usando Excel para gestionar el contexto?

La respuesta es simple: porque no tiene otra opción.

No hay una herramienta específica para gestionar datos contextuales de la forma en que se gestionan los datos transaccionales. Los catálogos de datos existen, pero tienen una implementación compleja y están pensados para el inventario, no para la gestión activa. Las wikis y documentos son estáticos. Los sistemas de MDM tradicionales son proyectos de consultoría de meses con costes que solo tienen sentido para organizaciones enterprise con equipos dedicados.

Para un equipo de datos de tamaño medio que necesita gobernar sus datos maestros hoy, Excel es literalmente la única opción accesible.

El coste que nadie calcula

El coste de este problema raramente aparece en un informe de gestión. No tiene una línea en el presupuesto. Pero existe.

Cada vez que un analista dedica dos horas a reconciliar versiones distintas de los mismos datos, ese tiempo tiene un coste. Cada vez que un cierre de mes se alarga porque los datos no cuadran y nadie sabe cuál es la fuente correcta, ese retraso tiene un coste. Cada vez que un proyecto de IA se para porque los datos de entrenamiento no están bien definidos y validados, esa paralización tiene un coste.

Y más allá del tiempo, hay un coste de confianza. Cuando el negocio no puede confiar en los datos que le da el equipo de datos — no porque el equipo haga mal su trabajo, sino porque el contexto de esos datos vive en sistemas informales y no gobernados — la relación entre datos y decisión se deteriora.

Qué cambiaría si existiera la herramienta correcta

Imagina que el catálogo de clientes no vive en un Excel compartido en Teams sino en un sistema con las siguientes características:

Cada campo tiene un tipo, una validación y un propietario asignado. Si alguien introduce un valor que no cumple las reglas, el sistema lo rechaza antes de guardar. Cuando alguien propone un cambio en los criterios de clasificación, hay un flujo de revisión — el cambio queda en borrador hasta que el responsable lo aprueba. Cada aprobación queda registrada con fecha, usuario y versión. Y cuando los datos se aprueban, se sincronizan automáticamente con BigQuery o Snowflake.

El cierre de mes ya no empieza con “¿qué versión del Excel estábamos usando?” porque hay una sola versión, aprobada, con historial completo.

Eso no es ciencia ficción. Es lo que debería haber existido hace tiempo.

El equipo de datos merece mejores herramientas

El equipo de datos no usa Excel porque quiere. Lo usa porque no tiene otra cosa.

Durante años, la industria ha invertido masivamente en hacer más potente la capa analítica — warehouses más rápidos, pipelines más robustos, visualizaciones más sofisticadas. Y todo eso es valioso.

Pero la capa de gobierno — el contexto que hace que la analítica tenga sentido — ha quedado relegada a hojas de cálculo y documentos informales. Y esa capa es la base de todo. Sin datos bien gobernados, la analítica miente. Sin datos bien contextualizados, la IA alucina.

Es hora de que el equipo de datos tenga una herramienta específica para gobernar lo que más importa: el conocimiento que rodea a los datos.

“La pregunta no es si tu equipo necesita una herramienta mejor para esto. La pregunta es cuánto tiempo más puede permitirse no tenerla”

¿Tienes un proyecto?

Llevamos más de 15 años ayudando a empresas a conseguir sus objetivos. Somos creativos, tenaces y nos encanta lo que hacemos.

¡Hagamos esa idea realidad!
¿Tienes Opera Cloud? Ya estamos integrados.
Artículos Artículos

¿Tienes Opera Cloud? Ya estamos integrados.

Mind Hotel Insights y Mind Ocean se integran con Oracle Hospitality para ofrecer una visión unificada de tus operaciones, sin importar cuántos sistemas gestiones.

Si tu hotel o grupo hotelero trabaja con Oracle Opera Cloud, tenemos una buena noticia: Mind Hotel Insights y Mind Ocean ya están integrados y disponibles directamente en el Oracle Marketplace. Un solo paso separa tus datos operativos de una analítica avanzada, consolidada y lista para tomar decisiones.

Lo sabemos bien: gestionar un entorno hotelero moderno no es sencillo. Múltiples propiedades, distintos sistemas, estructuras organizativas diferentes… y al final del día, alguien tiene que tener los números claros. Eso es exactamente lo que hacemos.

“Para los grupos hoteleros con entornos multi-propiedad y multi-PMS, somos el partner que consolida todo en una sola visión, sin importar cuántas variantes tenga tu ecosistema.”

Mind Hotel Insights convierte los datos de Opera Cloud en cuadros de mando ejecutivos, KPIs accionables y reporting automático. Sin exportaciones manuales, sin hojas de cálculo intermedias: la información que necesitas, cuando la necesitas.

Mind Ocean va un paso más allá y está diseñado para los entornos más complejos: agrega y normaliza datos de múltiples propiedades, distintos PMS y diferentes canales en una única capa de inteligencia. Si lideras un grupo con muchas variables, Mind Ocean es tu centro de control.

Nuestra presencia en el Oracle Marketplace no es solo un hito técnico: es una garantía de que somos un partner solvente y validado para los entornos hoteleros más exigentes. Si ya usas Opera Cloud, el camino hacia una gestión más inteligente es más corto de lo que crees

¿Hablamos? Nuestro equipo estará encantado de hacer una demo.

¿Tienes un proyecto?

Llevamos más de 15 años ayudando a empresas a conseguir sus objetivos. Somos creativos, tenaces y nos encanta lo que hacemos.

¡Hagamos esa idea realidad!
Mind Ocean: un Data Warehouse empresarial listo para usar
Artículos Artículos

Mind Ocean: un Data Warehouse empresarial listo para usar

Mind Ocean es una plataforma de Data Warehouse empresarial preconstruida que permite centralizar datos de múltiples sistemas y acelerar proyectos de analítica e IA. Con integraciones prefabricadas y una arquitectura optimizada para análisis y los MCPs, las empresas pueden construir su plataforma de datos corporativa mucho más rápido y empezar antes a generar valor.

El problema no es entender el Data Warehouse. Es construirlo.

Hoy casi todas las empresas entienden el valor de centralizar sus datos. La idea de un Data Warehouse corporativo está bien establecida: integrar información de múltiples sistemas, estructurarla bajo un modelo común y permitir que el negocio pueda analizar su actividad con una visión global. Sobre el papel, el concepto es sencillo. El problema aparece cuando llega el momento de construirlo.


Implementar una plataforma de datos no consiste únicamente en copiar información de un sistema a otro. Implica definir arquitectura, diseñar pipelines de integración, comprender la lógica de cada aplicación, modelar entidades de negocio, garantizar calidad del dato y preparar estructuras que permitan el análisis de forma eficiente.


En la práctica, muchas organizaciones descubren que antes de poder analizar su negocio, necesitan invertir meses —y a veces años— en construir la infraestructura que lo haga posible.
Ese esfuerzo inicial suele convertirse en el mayor obstáculo para avanzar.
Por eso cada vez más empresas están cambiando la forma de abordar este tipo de proyectos. En lugar de construir una plataforma completamente desde cero, empiezan a buscar soluciones que ya incorporen parte de ese trabajo estructural.
Ese es precisamente el enfoque con el que nace Mind Ocean.

Qué es Mind Ocean

Mind Ocean es una plataforma de Data Warehouse empresarial preconstruida, diseñada para acelerar la centralización y explotación de datos corporativos.
La idea es sencilla: en lugar de empezar desde una hoja en blanco, partir de una base que ya incorpora arquitectura, modelos de datos y mecanismos de integración.
Esta base permite conectar los sistemas de la empresa, transformar los datos y organizarlos bajo una lógica común que facilite el análisis. De esta forma, el tiempo que normalmente se dedica a construir la infraestructura técnica puede reducirse significativamente.
El objetivo no es eliminar la personalización, sino evitar reinventar constantemente los mismos cimientos. Muchas empresas se enfrentan a problemas muy similares cuando intentan integrar sus sistemas: cómo unificar clientes, cómo consolidar ventas, cómo relacionar operaciones con resultados financieros o cómo construir indicadores consistentes.
Mind Ocean parte de esa experiencia acumulada para ofrecer una estructura preparada para ese tipo de escenarios.

La arquitectura de Mind Ocean

Para entender cómo funciona la plataforma, es útil imaginarla como una estructura formada por distintas capas, cada una con un papel específico dentro del flujo de datos.
La primera capa está dedicada a conectar los sistemas operacionales de la empresa. En el día a día de cualquier organización conviven múltiples aplicaciones: sistemas ERP, herramientas CRM, plataformas financieras, aplicaciones sectoriales o servicios externos accesibles mediante APIs.
Cada uno de estos sistemas contiene una parte de la realidad del negocio. El reto consiste en extraer esa información de forma fiable y trasladarla a una plataforma común donde pueda ser combinada con el resto.
Mind Ocean incorpora mecanismos de integración que permiten realizar ese proceso de forma estructurada. En muchos casos, además, incluye conectores o patrones de integración ya preparados que reducen significativamente el tiempo necesario para empezar a trabajar con los datos.
Una vez que la información entra en la plataforma, comienza una segunda etapa clave: la transformación.
Los datos operacionales rara vez están listos para ser analizados directamente. Suelen tener estructuras pensadas para la operación diaria, no para el análisis transversal del negocio. En esta fase se aplican reglas de limpieza, normalización y consolidación que permiten construir entidades coherentes.
Es aquí donde diferentes fuentes de información empiezan a hablar el mismo idioma. Un cliente registrado en varios sistemas puede unificarse, las transacciones pueden relacionarse con productos y mercados, y los datos financieros pueden conectarse con operaciones o ventas.
A partir de este proceso se construye el núcleo de la plataforma: el Data Warehouse corporativo.
Este repositorio central organiza la información bajo un modelo de negocio consistente que permite analizar la empresa desde múltiples perspectivas. Ventas, clientes, operaciones, costes o indicadores financieros dejan de ser datos aislados para formar parte de una estructura común.
Cuando esta base está bien diseñada, las preguntas que antes requerían múltiples cruces manuales pueden responderse de forma directa y confiable.

Capa de consumo analítico

Una vez que los datos están estructurados dentro del Data Warehouse, pueden ser utilizados por distintos tipos de herramientas y procesos dentro de la organización.
Entre los usos más habituales se encuentran:

  • dashboards de negocio
  • aplicaciones analíticas
  • reporting financiero
  • modelos predictivos
  • agentes de inteligencia artificial
  • aplicaciones operativas basadas en datos

Esta capa es la que finalmente conecta la plataforma de datos con la toma de decisiones en la empresa.

El valor de las integraciones prefabricadas

Uno de los aspectos que más ralentiza los proyectos de datos es el desarrollo de integraciones. Cada sistema tiene su propia estructura, su propio modelo y sus propias reglas. Entender cómo extraer información, cómo transformarla y cómo integrarla con el resto de los datos suele requerir una inversión significativa de tiempo.
Mind Ocean aborda este problema incorporando integraciones y patrones de conexión ya preparados para sistemas habituales en las organizaciones. Esto no elimina la necesidad de adaptación, pero sí reduce considerablemente el esfuerzo inicial necesario para construir la plataforma.
El resultado es que las empresas pueden avanzar más rápido hacia la explotación analítica de los datos, en lugar de dedicar la mayor parte del proyecto a resolver cuestiones puramente técnicas.

Beneficios para la empresa

Adoptar una plataforma como Mind Ocean permite a las organizaciones avanzar con mayor rapidez hacia un modelo de gestión basado en datos.
Entre los beneficios más relevantes se encuentran:

  • Centralizar datos de múltiples sistemas bajo una estructura común
  • Reducir el tiempo necesario para construir una plataforma de datos corporativa
  • Disminuir el esfuerzo de desarrollo gracias a integraciones y modelos predefinidos
  • Acelerar proyectos de analítica y reporting empresarial
  • Crear una base sólida para analítica avanzada, predicción e inteligencia artificial

De la infraestructura al valor

Durante mucho tiempo, construir una plataforma de datos significaba dedicar una gran parte del proyecto a desarrollar infraestructura antes de poder empezar a generar valor.
La aparición de plataformas aceleradas como Mind Ocean cambia esa dinámica.
Cuando la arquitectura, los modelos y parte de las integraciones ya están preparados, el esfuerzo puede centrarse en lo realmente importante: comprender mejor el negocio, identificar oportunidades y mejorar la toma de decisiones.

En ese contexto, el Data Warehouse deja de ser solo una infraestructura técnica y pasa a convertirse en una pieza estratégica para el funcionamiento de la empresa.

Mind Ocean nace precisamente con ese objetivo: ayudar a las organizaciones a pasar más rápido de los datos dispersos a la inteligencia empresarial. AQUI ENCONTRARÁS TODA LA INFORMACIÓN DEL PRODUCTO

¿Tienes un proyecto?

Llevamos más de 15 años ayudando a empresas a conseguir sus objetivos. Somos creativos, tenaces y nos encanta lo que hacemos.

¡Hagamos esa idea realidad!
La nueva generación de plataformas de datos: construir más rápido, generar valor antes
Artículos Artículos

La nueva generación de plataformas de datos: construir más rápido, generar valor antes

Construir una plataforma de datos desde cero puede convertirse en un proyecto largo y complejo. Por eso cada vez más empresas están adoptando plataformas de datos aceleradas, que incorporan arquitectura, integraciones y modelos analíticos ya preparados. En este artículo exploramos cómo este enfoque está cambiando la forma en que las organizaciones construyen sus plataformas de datos.

Después de comprender qué es un Data Warehouse y los desafíos que implica construir uno desde cero, muchas empresas llegan a una conclusión similar: el mayor esfuerzo de estos proyectos no está en analizar datos, sino en construir la infraestructura necesaria para que ese análisis sea posible.
Integrar sistemas, desarrollar pipelines de datos, diseñar modelos analíticos, gestionar la calidad de la información y mantener la plataforma operativa requiere una inversión considerable de tiempo y recursos.
En muchos proyectos, la mayor parte del esfuerzo se destina a resolver problemas técnicos relacionados con la arquitectura de datos, mientras que el análisis de negocio —que era el objetivo original— queda en segundo plano.
Este fenómeno ha llevado a muchas organizaciones a replantearse cómo construyen sus plataformas de datos.
En lugar de desarrollar cada componente desde cero, cada vez más empresas están adoptando un enfoque distinto: plataformas de datos aceleradas.

De proyectos artesanales a plataformas reutilizables

Durante muchos años, los proyectos de Data Warehouse se abordaban como desarrollos completamente personalizados. Cada empresa diseñaba su propia arquitectura, desarrollaba sus integraciones y construía sus modelos de datos desde cero.
Este enfoque ofrecía flexibilidad, pero también generaba proyectos largos y complejos.
Con el tiempo, muchas organizaciones empezaron a observar que gran parte del trabajo que realizaban en estos proyectos se repetía una y otra vez. Integraciones similares, modelos de negocio comparables y arquitecturas que compartían principios comunes.
A partir de esta experiencia comenzó a surgir una nueva forma de abordar estos proyectos: construir plataformas reutilizables que ya incorporan una parte importante de esa infraestructura.
En lugar de empezar desde una hoja en blanco, las empresas pueden partir de una base ya preparada.

Qué es una plataforma de datos acelerada

Una plataforma de datos acelerada es una infraestructura que ya incorpora componentes fundamentales para la construcción de una plataforma analítica.
En lugar de desarrollar cada elemento individualmente, estas soluciones incluyen elementos que normalmente forman parte de cualquier arquitectura de datos moderna.
Entre ellos suelen encontrarse:

  • arquitectura de datos preparada para entornos cloud
  • pipelines de ingestión y transformación de datos
  • modelos de datos orientados al análisis empresarial
  • integraciones con sistemas comunes
  • estructuras optimizadas para herramientas analíticas

El objetivo no es eliminar la personalización, sino reducir el trabajo repetitivo que aparece en casi todos los proyectos de datos.

Reducir la fricción para llegar antes al valor

Cuando una empresa parte de una plataforma acelerada, gran parte de la infraestructura ya está preparada.
Esto significa que el proyecto puede avanzar más rápidamente hacia las fases que realmente generan valor para el negocio: el análisis, la interpretación de datos y la toma de decisiones.
En lugar de dedicar meses a construir pipelines básicos o definir estructuras comunes, los equipos pueden concentrarse en adaptar la plataforma a las necesidades específicas de la organización.
Este cambio de enfoque reduce significativamente el tiempo necesario para construir una plataforma de datos funcional.

La importancia de las integraciones prefabricadas

Uno de los aspectos que más trabajo genera en los proyectos de datos es la integración de sistemas.
Cada ERP, CRM o aplicación operativa tiene su propia estructura de datos, su propia lógica y sus propias formas de acceso a la información.
Desarrollar conectores e integraciones para cada sistema suele requerir un esfuerzo considerable.
Las plataformas aceleradas abordan este problema incorporando integraciones prefabricadas con sistemas ampliamente utilizados en las organizaciones.
Esto permite acelerar significativamente la fase inicial del proyecto y facilita que los datos empiecen a fluir hacia la plataforma analítica en menos tiempo.

Plataformas diseñadas para la empresa moderna

Otro elemento importante de estas plataformas es que suelen estar diseñadas teniendo en cuenta las necesidades actuales de las organizaciones.
No solo están pensadas para generar informes tradicionales, sino también para soportar un ecosistema analítico más amplio.
Las empresas modernas utilizan sus plataformas de datos para múltiples propósitos:

  • reporting empresarial
  • análisis de negocio
  • optimización operativa
  • previsión de demanda
  • modelos de inteligencia artificial

Por ello, las plataformas aceleradas suelen incorporar arquitecturas preparadas para soportar distintos tipos de análisis y herramientas.

Un cambio de paradigma en la construcción de plataformas de datos

La aparición de plataformas aceleradas representa un cambio importante en la forma en que las empresas abordan sus proyectos de datos.
En lugar de construir cada componente de la arquitectura desde cero, las organizaciones pueden apoyarse en estructuras ya probadas y adaptarlas a su contexto específico.
Este enfoque permite reducir riesgos, acelerar proyectos y concentrar el esfuerzo en generar valor a partir de la información.
A medida que la importancia de los datos continúa creciendo dentro de las organizaciones, es probable que este tipo de plataformas se convierta en una parte cada vez más habitual de las arquitecturas empresariales.

El siguiente paso: plataformas diseñadas para acelerar la centralización de datos

Las plataformas aceleradas representan un paso importante en la evolución de las arquitecturas de datos. Permiten a las empresas construir infraestructuras analíticas más rápidamente y reducir la complejidad técnica de estos proyectos.

En el próximo artículo veremos un ejemplo concreto de este enfoque: Mind Ocean, una plataforma diseñada para acelerar la construcción de un Data Warehouse corporativo mediante integraciones y modelos de datos ya preparados.

¿Tienes un proyecto?

Llevamos más de 15 años ayudando a empresas a conseguir sus objetivos. Somos creativos, tenaces y nos encanta lo que hacemos.

¡Hagamos esa idea realidad!
Por qué construir un Data Warehouse desde cero es más difícil de lo que parece
Artículos Artículos

Por qué construir un Data Warehouse desde cero es más difícil de lo que parece

Construir un Data Warehouse parece una idea sencilla: integrar datos de distintos sistemas y analizarlos en un repositorio central. Sin embargo, en la práctica estos proyectos suelen enfrentarse a múltiples desafíos técnicos y organizativos. En este artículo exploramos por qué construir una plataforma de datos desde cero es más complejo de lo que parece.

Cuando la idea parece sencilla… pero la implementación no lo es

Después de entender el valor de centralizar datos y de conocer qué es un Data Warehouse, muchas empresas llegan naturalmente a la misma conclusión: necesitan construir una plataforma de datos que integre la información de toda la organización.

Sobre el papel, el objetivo parece bastante claro. Integrar datos de distintos sistemas, organizarlos bajo un modelo común y utilizarlos para generar análisis e indicadores de negocio.

Sin embargo, cuando las organizaciones empiezan a recorrer ese camino, descubren rápidamente que el desafío es mucho mayor de lo que imaginaban.

El concepto de Data Warehouse es relativamente sencillo de entender. Lo complicado es construirlo y hacerlo funcionar de forma fiable a lo largo del tiempo.

El primer desafío: integrar sistemas muy diferentes

El primer obstáculo suele aparecer en el momento de conectar los distintos sistemas de la empresa.

Cada aplicación ha sido diseñada con su propio modelo de datos, su propia lógica de negocio y sus propias reglas internas. Un ERP puede estructurar la información de clientes de una forma completamente distinta a un CRM. Las herramientas financieras pueden utilizar calendarios contables diferentes a los sistemas operativos. Las aplicaciones sectoriales suelen tener modelos específicos que no encajan fácilmente con otros sistemas.

Cuando estos datos se intentan integrar, aparecen múltiples preguntas:

  • ¿Cómo se identifica un cliente cuando aparece en varios sistemas?
  • ¿Qué sistema contiene la información “correcta”?
  • ¿Cómo se gestionan las diferencias en estructuras de datos?
  • ¿Qué ocurre cuando distintos sistemas utilizan definiciones diferentes para la misma métrica?

Resolver estas cuestiones requiere comprender profundamente cómo funcionan los sistemas y cómo se relaciona la información entre ellos.

El segundo desafío: transformar datos operacionales en información analítica

Incluso cuando los datos pueden extraerse de los sistemas operativos, rara vez están preparados para ser analizados directamente.

Los sistemas transaccionales están diseñados para registrar operaciones del día a día: pedidos, facturación, pagos, movimientos de inventario o actividad comercial. Su estructura prioriza la eficiencia operativa, no la facilidad de análisis.

Para que estos datos puedan utilizarse en análisis de negocio, deben pasar por procesos de transformación.

Durante esta etapa se realizan tareas como:

  • limpiar inconsistencias
  • normalizar formatos
  • consolidar entidades de negocio
  • historizar información
  • aplicar reglas de negocio

Este trabajo es fundamental para construir un modelo de datos coherente que permita analizar el negocio de forma consistente.

El tercer desafío: diseñar un modelo de datos que represente el negocio

Uno de los aspectos más complejos de un Data Warehouse es el diseño del modelo de datos.

El objetivo no es simplemente almacenar información, sino representarla de una forma que facilite el análisis del negocio.

Esto implica definir entidades clave como clientes, productos, ventas, transacciones o indicadores financieros, y establecer cómo se relacionan entre sí.

Un buen modelo de datos permite responder preguntas complejas con relativa facilidad. Un modelo mal diseñado puede convertir cada análisis en un ejercicio complicado y lento.

Por eso, el modelado de datos es una de las áreas más críticas dentro de cualquier proyecto de Data Warehouse.

El cuarto desafío: mantener la calidad y coherencia de los datos

Una vez que el Data Warehouse está construido, aparece un nuevo reto: mantenerlo actualizado y garantizar que la información siga siendo confiable.

Los sistemas operacionales cambian con el tiempo. Se incorporan nuevas aplicaciones, se modifican procesos y aparecen nuevas fuentes de datos.

Cada uno de estos cambios puede afectar a los pipelines de integración y a los modelos de datos existentes.

Además, la calidad del dato se convierte en un factor crítico. Si los datos que alimentan el Data Warehouse contienen errores o inconsistencias, los análisis generados a partir de ellos también se verán afectados.

Por eso, muchas plataformas de datos incorporan mecanismos de validación, monitorización y control de calidad que permiten detectar problemas antes de que afecten a los análisis.

El quinto desafío: escalar la plataforma con el crecimiento del negocio

A medida que la empresa crece y adopta nuevas herramientas, el volumen y la variedad de datos aumentan.

La plataforma de datos debe ser capaz de adaptarse a ese crecimiento sin perder rendimiento ni fiabilidad.

Esto implica diseñar arquitecturas que puedan escalar en almacenamiento, procesamiento e integración de nuevas fuentes.

Las tecnologías cloud han facilitado mucho este proceso, pero la complejidad arquitectónica sigue siendo un factor importante en este tipo de proyectos.

Cuando la infraestructura consume el proyecto

Por todas estas razones, muchas empresas descubren que el mayor esfuerzo de un proyecto de Data Warehouse no está en analizar datos, sino en construir y mantener la infraestructura necesaria para que esos análisis sean posibles.

Los equipos terminan dedicando gran parte del tiempo a desarrollar integraciones, mantener pipelines, resolver inconsistencias y adaptar modelos de datos.

El análisis de negocio —que era el objetivo inicial del proyecto— queda a veces relegado a un segundo plano.

Hacia una nueva forma de construir plataformas de datos

En los últimos años, este desafío ha llevado a muchas organizaciones a replantearse cómo abordan la construcción de sus plataformas de datos.

En lugar de desarrollar cada componente desde cero, algunas empresas están empezando a adoptar enfoques más acelerados que reutilizan arquitecturas, integraciones y modelos ya preparados.

Este tipo de plataformas permiten reducir significativamente el tiempo necesario para construir un Data Warehouse y facilitan que los equipos se concentren en generar valor a partir de los datos.

En el próximo artículo veremos cómo está emergiendo una nueva generación de plataformas de datos aceleradas que buscan simplificar la construcción de estas infraestructuras y acelerar los proyectos de analítica empresarial.

¿Tienes un proyecto?

Llevamos más de 15 años ayudando a empresas a conseguir sus objetivos. Somos creativos, tenaces y nos encanta lo que hacemos.

¡Hagamos esa idea realidad!